|
從像素到預測:藉助 AMD Vitis AI 的 GStreamer 加速邊緣 AI 流程
將神經網路部署至邊緣硬體上聽起來簡單,但實際操作卻並非如此。您在 PyTorch 中訓練了一個模型,獲得良好的準確度,接著卻面臨一系列陌生的問題:如何在不影響準確度的前提下降低數值精度位元寬度?如何針對特定的自適應 SoC 進行部署?如何以盡可能低的開發工作量,將推論無縫整合至即時視訊流程中?其中每一個步驟,本身都可能需要數週的工程投入。AMD Vitis AI 與 Vitis 視訊分析 SDK( Vitis Video Analytics SDK,VVAS )正是為了補足這些缺口而設計。
為了瞭解這些工具的作用,首先需要從端對端的角度,想象一個完整的 AI 視訊分析應用是什麼樣的。視訊資料來自一個或多個來源,例如文件、IP 攝影機或 IoT 感測器,並依次經過多個階段:擷取與解碼、前處理、推論、後處理與渲染,最终進入儲存、顯示或串流媒體輸出端點。每個階段都需要高效執行,同時各階段之間必須協同運作,以避免不必要的資料複製或 CPU 瓶頸。圖 1 顯示一個典型流程,其中 Vitis AI 負責加速機器學習推論階段,而 VVAS(基於 GStreamer )則負責連接並編排圍繞該階段的各個流程元素。
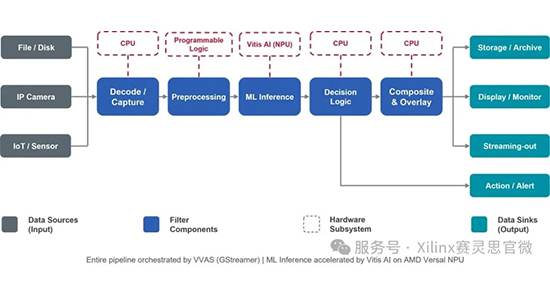
圖 1:典型視訊分析流程——Vitis AI 為執行在 AMD Versal NPU 上的機器學習推論階段提供支援;VVAS(基於 GStreamer 建構)連接並編排從來源到輸出的整體流程。
從訓練到部署:複雜性從何而來
圖 1 中的流程看起來非常清楚。但在實際建構中,如果没有適合的工具,專案進度就會放缓。以下進一步說明真正的痛點所在。
從訓練到推論缺乏明確路徑。
大多數開發者都熟悉 PyTorch 或 TensorFlow,但這些框架並不會直接為 AMD NPU(Neural Processing Unit,神經處理單元;在第二代 AMD Versal AI Edge 系列元件中作為基於 AI 引擎建構的 AI 推論加速器)提供二進位檔案。
量化是一大挑戰。
如果只是簡單地將 FP32 權重轉換為 INT8,而没有進行適當的校正或調校,可能會導致明顯的準確度損失。找到適合的校正策略、處理混合精度需求(例如,在 YOLO 後處理中保留更高精度,以避免尺度不匹配)以及驗證結果,都需要專業知識和工具。
視訊流程整合是一項獨立的工程問題。
即使推論已經可以執行,將其與即時視訊串流整合起來,包括硬體加速前處理、中繼資料傳遞、邊界框叠加以及多路視訊串流管理,仍然需要對 GStreamer 和自適應 SoC 或 FPGA 具備深入瞭解。大多数 AI 開發人員並不具備這樣的背景。
效能分析與除錯並不容易。
當延遲较高時,很难確認瓶頸究竟來自 NPU、CPU 回退、前處理還是後處理。如果缺乏良好的可觀測性工具,最佳化就只能依靠猜測。
上述每一項缺口都與 Vitis AI 或 VVAS 的某項功能直接對應。讓我們從模型侧開始,逐步瞭解工具鏈是如何解決這些問題的。
Vitis AI:補足模型到 NPU 的缺口
Vitis AI 提供了一套完整的整合工具鏈,可將 ONNX 模型轉換為經過最佳化、在第二代 Versal AI Edge 系列元件上執行的 NPU 可執行文件。在深入瞭解各個階段之前,有必要先了解軟體堆疊各層之間的關係。在最上層,開發者可以使用熟悉的機器學習框架,例如 PyTorch 和 TensorFlow。標準開源模型可以從這些框架匯出為 ONNX 格式。Vitis AI 工具( AMD Quark 用於量化,Vitis AI Compiler ( Vitis AI 編譯器)用於針對特定硬體的最佳化)位於中間層,負責將這些模型轉換為高效率的 NPU 二進位檔案。在執行階段,兩條 API 路徑(即带有 Vitis AI Execution Provider 的 ONNX Runtime,以及原生 VART 執行階段)會透過彈性執行階段( XRT )層呼叫硬體。下圖顯示這套完整軟體堆疊:
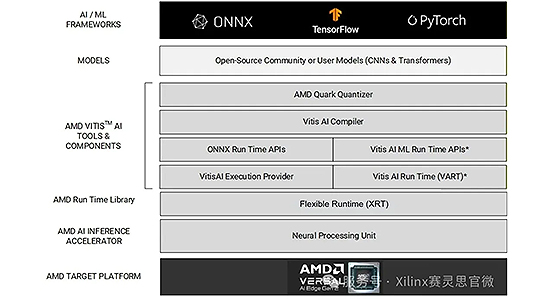
圖 2:Vitis AI 軟體堆疊——AMD Quark Quantizer 和 Vitis AI 編譯器位於 ONNX 與 VART 執行階段之上,透過 AMD Versal 平台上的彈性執行階段( XRT )驅動神經處理單元( NPU )。
以下說明各階段可提供哪些能力。
藉助 AMD Quark 進行量化
AMD Quark 是 Vitis AI 中包含的量化工具套件。Vitis AI 編譯器支援三種精度模式,以因應不同的效能與準確度取捨。對於 FP16 和 INT8,Vitis AI 使用 AMD Quark 作為量化工具套件。
• BF16(自動):Vitis AI 編譯器會在編譯過程中自動將 FP32 模型轉換為 BF16,無需校正。這是建議的入門解決方案。
• FP16:透過 Quark 進行明確轉換,適用於視覺 Transformer 架構,因為在這類架構中,BF16 可能帶來過大的準確度損失。
• INT8(高效能):使用小規模校正資料集進行訓練後量化。相較 FP16 或 BF16,它能提供更高的吞吐量和更低的延遲,但會犧牲部分準確度。
對於像 YOLO 這樣的模型,INT8 會因後處理中的尺度不匹配而導致準確度受到影響,Vitis AI 可透過混合精度應對:將運算密集型核心量化為 INT8,同時將準確度敏感的後處理保留為 FP32,編譯器會自動將這些 FP32 子圖轉換為 BF16,從而使整個模型仍能在 NPU 上執行。
編譯
Vitis AI 編譯器接收 ONNX 模型,並產生針對 NPU 最佳化的二進位檔案。它會自動處理運運算子融合、記憶體排程以及 CPU/NPU 分割區。您只需透過一個 JSON 文件對其進行設定,在文件中指明目標裝置和最佳化偏好。
Vitis AI 編譯器支援兩種平行化策略,即資料平行和張量平行,以最佳化模型在 NPU 硬體上的效能。資料平行(批次處理)會在多個 NPU 運算區塊上複製完整模型,使多個獨立推論請求可以並行執行。因此,它非常適合多攝影機視訊串流這類高吞吐量情境。張量平行會將單一推論請求劃分到多個 NPU 運算單元上,以並行方式執行,從而降低每個請求的延遲,並支援超出单個 NPU 運算區塊記憶體容量的模型。選擇哪種策略取決於您的應用需求:資料平行更適合針對吞吐量的工作負載,而張量平行更適合對延遲敏感或内存受限的用例。Vitis AI 能够將工作負載實體分割到專用 AI 引擎上(後文稱為“空間分割”),這是一項重要能力,有助於設計人員降低功耗並提升延遲確定性。
編譯完成後,AI Analyzer( AI 分析器)會提供視覺化的分析結果,顯示哪些運算子執行在 NPU 上,哪些運算子退回 CPU 執行 上,從而協助您確認需要最佳化的位置。以下的 AI Analyzer 範例圖顯示了運算子如何在 NPU 和 CPU 之間進行分割區。
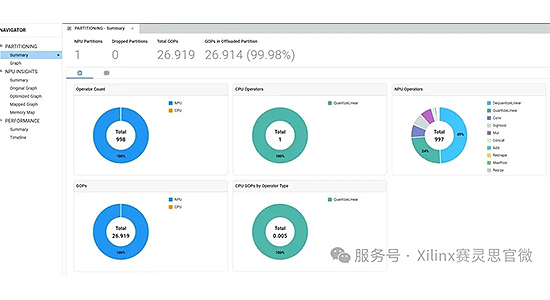
圖 3:AI Analyzer 顯示 NPU 與 CPU 之間的運算子分割區情況。
部署執行階段
Vitis AI 提供兩種執行階段,以適配您的部署階段。具體應選擇哪種執行階段,取決於您的應用對執行細節控制程度的需求。
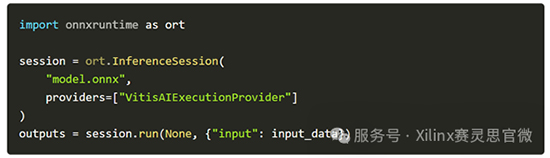
ONNX Runtime + Vitis AI Execution Provider 是執行推論的最快速的路徑。如果您的應用已採用 ONNX Runtime 建構,那麼加入 Vitis AI Execution Provider 只需要極少的修改。您只需傳入 provider 名稱和已編譯模型,ONNX Runtime 就會自動對運算子進行分割區,將支援的運運算子傳送至 NPU,其餘運算子则退回 CPU 執行。對於希望保留既有基於 ONNX Runtime 的技術堆疊並啟用硬體加速的團隊來说,這是一個切實可行的選擇。
VART-ML 是針對量產環境的高效能 C++ 執行階段。對於完全卸載到 NPU 上的模型,它有助於徹底消除 CPU 回退負擔,並支援零複製執行。因此,當應用需要更嚴格地控制執行階段行為和效能調校時,VART-ML 是更適合的選擇。
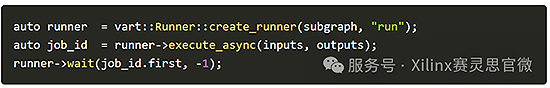
總結而言:ONNX Runtime 提供了一條熟悉的整合路徑,可以快速啟動並執行;而當您需要對執行過程進行更直接的控制並追求盡可能低的延遲時,VART 是更適合的選擇。
易用性與開箱即用體驗
上手流程快速且直接。預先建置 Docker 映像檔包含所有量化和編譯工具。針對第二代 AMD Versal AI Edge 系列 VEK385 評估板的預先建置啟動映像檔,讓您在首次開機後數分鐘内即可執行 ResNet50 推論。Python™ API 可實作快速原型開發;C++ API 可擴充至量產環境。這種開箱即用體驗代表,您可以將時間投入到應用開發,而非環境建置上。
當模型已經完成量化、編譯並可在 NPU 上執行後,您仍需解決另一項挑戰:將實際應用中圍繞推論的元件整合起來,包括視訊解碼、前處理、中繼資料傳遞以及多接收端輸出路由。這正是 VVAS 的發揮作用之處。
VVAS:補足流程整合缺口
當 Vitis AI 負責模型量化、編譯和 NPU 執行之後,下一個問題是:是什麼將圖 1 中所示的所有流程階段串接起來?解決解決方案就是 VVAS。如果没有 VVAS,流程中的每一次銜接,包括將影格解碼為正確的緩衝區格式、將其送入可程式化邏輯( PL )前處理核心、將結果傳遞给 NPU 推論、向叠加階段傳遞中繼資料以及將輸出路由到多個接收端,都需要獨立的客製化整合專案,並且需要對 GStreamer 以及自適應 SoC 或 FPGA 具備深入的專業知識。
VVAS 藉助開源 GStreamer 技術,透過一個簡潔的外掛式 SDK 處理所有這些複雜工作。如下架構圖所示,您的應用位於最上層,直接使用 VVAS 插件;而 VVAS 则負責管理底層各層,包括 GStreamer、Vitis AI、XRT 和 NPU。
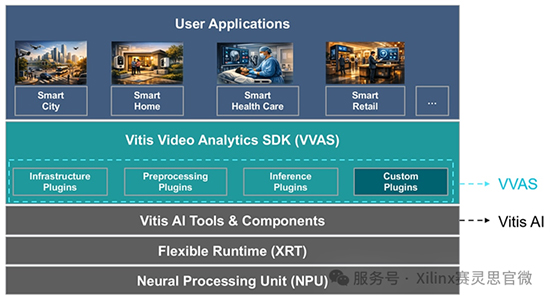
圖 4:VVAS 架構——使用者應用位於最上層;VVAS 插件層(基礎架構、前處理、推論和客製化外掛)銜接 GStreamer、Vitis
流程中的每個階段都直接對應到一個專用的 VVAS 外掛,透過 JSON 文件進行設定,無需客製化 C++ 或 GStreamer 樣板程式碼:
• vvas_xabrscaler:
提供硬體加速的尺寸縮放、色彩轉換和正規化,前處理不會帶來 CPU 負擔。
• vvas_xinfer:
機器學習推論外掛,支援 ONNX Runtime 和 VART 後端。負責批次處理、中繼資料產生和 NPU 執行。
• vvas_xmetaconvert / vvas_xoverlay:
解析推論中繼資料,並直接在輸出影格上繪製邊界框、標籤和形狀。
• vvas_xmetaaffixer:
支援在不同解析度的視訊流之間傳遞中繼資料。
• vvas_xmulticrop / vvas_xfunnel / vvas_xdefunnel:
支援感興趣區域裁剪、視訊串流合併與拆分,用於串接式多模型流程。
為了更具體地說明,以下範例顯示了一個完整的 YOLOX 物件偵測流程在實務上的實作方式,包括從檔案讀取、解析原始視訊、執行推論、轉換中繼資料、叠加結果,並將輸出傳送至接收端。所有這些步骤都可以用一條 gst-launch 指令來表達。
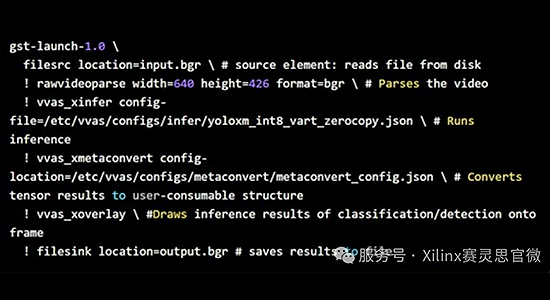
用於推論和中繼資料轉換的 JSON 文件如下:
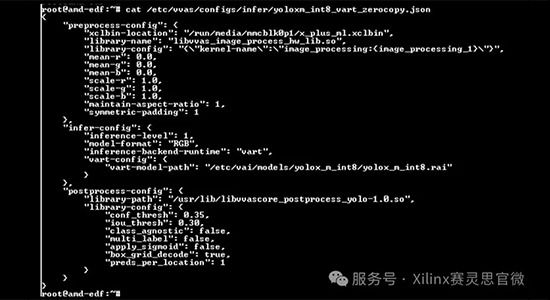
>>> (a) 推論 JSON ________________________
>>> (b) 中繼資料轉換 JSON ________________________
這種流程方式使您可以繼續使用熟悉的媒體框架,同時在分析流程的每個階段充分利用具備硬體感知能力的插件。Vitis 它無需客製化緩衝區管理,也不需要深入掌握 GStreamer 內部機制,而是依靠透過 JSON 設定定義的簡單、直接的插件組合來完成建構。
VVAS 還支援 Vitis AI 提供的進階部署設定,否则這些設定通常需要大量客製化工程:空間分割(兩個模型在獨立的 NPU 欄分割區上並行執行)、時間共享(多個模型在同一 NPU 資源上進行分時多工),以及零複製推論( DMA-BUF 和 XRT 緩衝區物件直接傳遞给 NPU,無需中間複製)。
在效能分析方面,VVAS 使用標準 GStreamer tracer。您可以使用 fpsdisplaysink 量測每秒影格數,使用 GST_TRACERS="latency" 量測延遲,並使用 GST_TRACERS="rusage" 量測 CPU 使用率。GStreamer 流程常用的可觀測性方法同樣適用於此。
整體而言,Vitis AI 與 VVAS 涵蓋了完整流程:從訓練好的浮點數模型,一直到經過效能分析、可投入量產並執行在第二代 AMD Versal AI Edge 系列硬體上的視訊分析應用。以下可以這樣瞭解二者各自帶來的價值。
核心重點
AI 流程開發並不僅限於模型本身。真正的挑戰在於將模型最佳化、執行階段執行、媒體處理、詳細的效能分析洞察以及硬體加速整合至可維護的應用中。這也正是 Vitis AI 與 VVAS 組合的優勢所在:一個負責模型準備和 NPU 執行,另一個则對周邊流程進行結構化和編排。
兩者結合,可協助您:
• 最佳化吞吐量與延遲:
針對整個嵌入式 AI 流程。
• 降低開發工作量:
透過重複使用經過驗證的模型量化、編譯和流程基礎架構,而非從零開始建構整套流程。
• 最大程度減少整合作業:
VVAS 和 Vitis AI 能够處理執行階段、緩衝區管理和媒體階段之間的複雜性。
• 加速原型開發:
藉助可重複使用的外掛元件、預先建置的啟動映像檔和 Python API,更快實作可執行的概念驗證。
• 縮短邁向量產的路徑:
用於快速原型開發的同一套工具鏈,也可以藉助 VART 和零複製推論擴充到經過最佳化的量產級部署。
結語
本文中的範例,從簡單的三行 ONNX Runtime 工作階段,到用單條指令表達的完整 YOLOX GStreamer 流程,顯示了這套工具鏈在實務上的運作方式。這些範例也說明,邊緣 AI 部署中的難點完全可以解決;關鍵在於在適當的層級使用適當的抽象層。
Vitis AI 和 VVAS 正是提供這些抽象的工具。無論您是從 PyTorch 模型起步,需要找到通往 NPU 的路徑,還是已經完成推論、需要將其接入即時視訊串流,這套工具鏈都能在您目前所處的位置提供支援,並随着需求成長而擴充。對於在第二代 Versal AI Edge 系列上建構即時 AI 應用的團隊,Vitis AI、VVAS、Quark 和 AI Analyzer 提供了必要的基礎架構與工具,協助設計人員順利實作、最佳化並將其设计部署到量產環境。
準備開始了嗎?
歡迎參閱 Vitis AI 6.2 使用者指南和 VVAS 6.2 使用者指南,取得完整文件、快速入門教學,以及基於第二代 AMDVersal AI Edge 系列 VEK385 評估板的預先建置範例。
閱讀原文 |