|
AMD 布局實體 AI:從運算晶片到機器人生態系
2026 年生成式 AI 應用持續蓬勃發展,全球科技產業正從數位智慧加速邁向實體智慧。從人形機器人、手術機器人到智慧工廠設備、自主物流系統等領域,機器人與智慧設備所能承擔的任務日益重要。如今人們對 AI 的要求也不再僅滿足於雲端推論或簡單自動化,早在 2020 年便提出的實體 AI( Physical AI )概念,如今終於迎來大展身手的時刻。
作為市場上唯一能同時生產高效能 CPU 與 GPU 的企業,AMD 也很快掌握這項市場趨勢,在為期數天的 Advancing AI 2026 大會上發表 Ryzen AI 嵌入式 X100 系列處理器,公布 Kria AI 解決方案,同時介紹全新 AMD Robotics Partner Network( AMD 機器人合作夥伴網路),
AMD 希望以開放式軟硬體全端生態系推動實體 AI 在實際場域的大規模部署。
01 - Ryzen AI 嵌入式 X100 系列處理器:專為實體 AI 而生
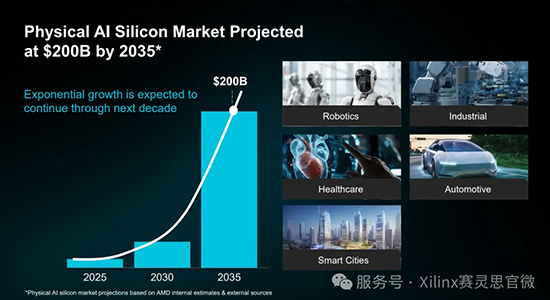
許多對產業不熟悉的使用者,對實體 AI 可能仍停留在概念階段。事實上,若非生成式 AI 持續取得突破,實體 AI 也很難快速發展,但其迭代速度已超乎人們想像,而這個市場的潛力在產業界也有目共睹。根據 AMD 預測,實體 AI 市場預計於 2025 至 2035 年維持指數級成長,並很可能在 2035 年達到 2,000 億美元規模,意味著未來幾年內,我們很可能看到科幻電影與遊戲中的「智慧機器」走進各大企業與工廠發揮作用。
而實體 AI 的崛起也象徵 AI 技術演進已進入新階段。企業對 AI 的要求也不再侷限於服務生成式 AI 或大型語言模型,而是需要 AI 不僅能理解資料,更能在真實環境中進行感知與推論,進而依需求做出決策並安全執行動作。因此實體 AI 系統要求智慧設備或機器人必須在邊緣與嵌入式環境中,同時滿足多項嚴苛條件。設備需要在有限的功耗與散熱條件下,實現高效能 AI 推論與確定性即時控制。
傳統 AI 解決方案或機器人難以跟上實體 AI 時代並不難理解,因為 AI 若要應用於各個領域,並非只需打造單一硬體或單一軟體即可完成,而是需要一套完整的供應鏈體系。從底層硬體到軟體生態系,都意味著這個產業需要一套涵蓋軟硬體的完整產業矩陣加以引領,才能避免因缺乏預先驗證、開發週期過長、生態封閉等問題形成惡性循環,進而影響產業發展。
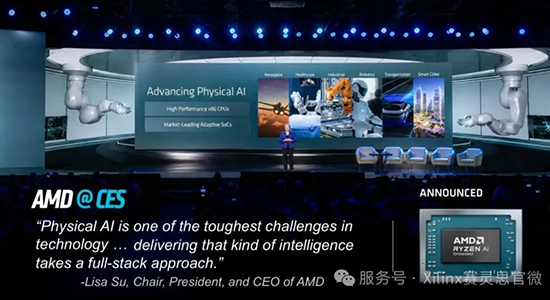
在今年的 CES 上,AMD 董事會主席暨執行長 Lisa Su 博士便表示:「實體 AI 是技術領域中最棘手的挑戰之一,而要實現這種等級的智慧,必須採用全端式解決方案。」因此,在看見產業痛點、需求與市場前景後,AMD 於 Advancing AI 2026 大會上的新品技術發表與生態系布局也就不難理解。
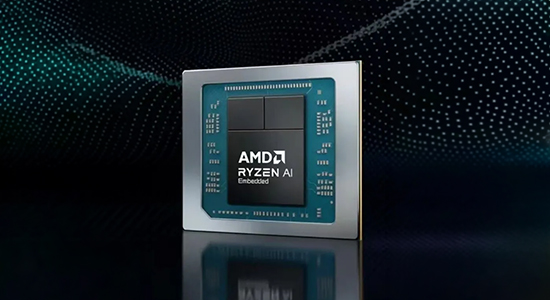
首先在產品方面,AMD 的反應一如既往迅速。AMD 本次發表的核心硬體是 Ryzen AI 嵌入式 X100 系列處理器。X100 系列處理器專為實體 AI 工作負載而設計,在單顆嵌入式 SoC 上整合最多 16 個高效能 AMD Zen 5 CPU 核心,搭載 RDNA 3.5 架構 iGPU,以及具備 50 TOPS 運算效能的 XDNA 2 NPU。 三大運算引擎皆具備卓越的獨立效能,這點在消費級市場中大家早已耳熟能詳。同時 X100 系列處理器統一內建 128GB 記憶體,最高加速時脈 5.1GHz,可支援全年無休全天候運作,使用壽命長達 10 年。
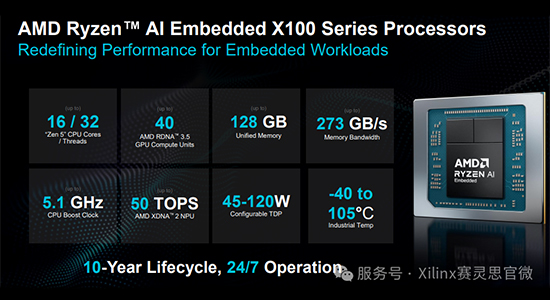
X100 系列處理器此次提供三款型號,分別為 X199、X188、X168。此外,AMD 為每個型號分別推出標準版與帶有 i 後綴的工業版,因此總共有 6 款 SKU。標準版工作溫度範圍為 0℃ 至 105℃,工業版工作溫度範圍則為 -40℃ 至 105℃。
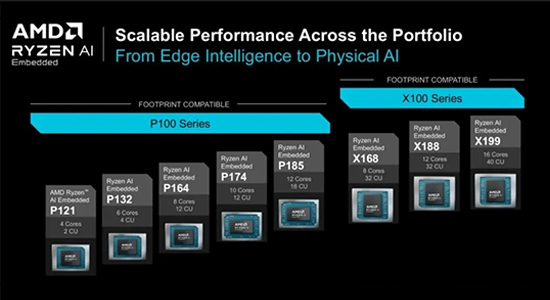
X199 為這次 X100 系列處理器的旗舰型号,擁有 16 核心 32 線程,GPU 配備 40 个 RDNA 3.5 運算單元。而 X188 则擁有 12 核心 24 線程,GPU 配備 32 个 RDNA 3.5 運算單元。X168 则擁有 8 核心 16 線程,GPU 同樣配備 32 个 RDNA 3.5 運算單元。
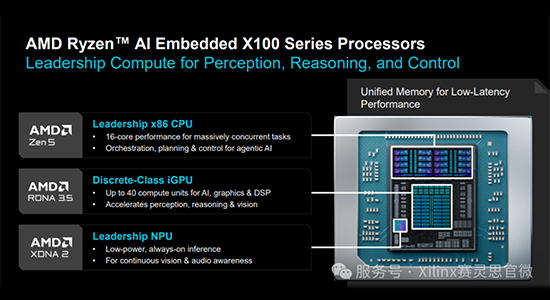
在效能應用方面,X100 系列憑藉先進 Zen 5 架構帶來的多核心領先優勢,可因應工業自動化即時控制、服務型機器人運動閉迴路控制等需要即時控制與多工處理的場景。此外,強大的 RDNA 3.5 圖形處理能力,可支援智慧設備執行更高效能的圖形處理任務。在 AI 工作負載方面,X100 系列也帶來更高的 Token 生成吞吐量與更快的首個 Token 生成時間( TTFT ),加速實體 AI 推論。同時在訊號處理方面,X100 系列強大的峰值 FP32 效能在高階醫療超音波波束成形等應用上表現出色,平均效能亦具備優勢。
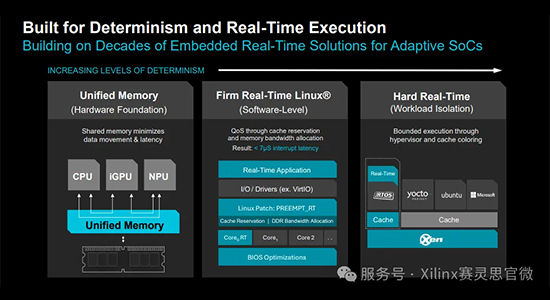
綜合來看,X100 系列主要針對機器人、工業自動化、醫療健康及其他智慧即時嵌入式系統進行最佳化,能在嚴格限制下支援自主系統可靠地進行感知、推論與行動。
在軟體支援方面,AMD 也為 X100 系列奠定良好基礎,支援 Linux 作業系統、AMD ROCm 軟體堆疊、Xen Hypervisor 虛擬化,以及 PyTorch、ONNX、TensorFlow 等主流 AI 框架。開發者可運用 CUDA 至 ROCm 移轉工具,在熟悉的環境中快速建構應用。
目前 AMD 表示,X100 系列處理器已於 2026 年 6 月向客戶提供樣品,預計於 2026 年第四季量產。並可透過 Arbor、Congatec、iBase、IEI、Sapphire 與 Seavo 等首波合作夥伴的系統模組,協助客戶快速推進至量產階段。
02 - Kria AI 解決方案讓機器人更像人
前面也提到,AMD 的目標是透過全端生態系推動實體 AI 發展。Ryzen AI 嵌入式 X100 系列的推出,象徵實體 AI 運算核心正式問世,但仍需要能充分發揮核心能力的載體。在消費級領域,這個載體是主機板與主機。而面向實體 AI 領域,AMD 以 X100 為基礎推出全新 Kria AI 解決方案,包括搭載 X100 系列處理器的 Kria AI SOM、機器人載板,以及 Kria AI 機器人開發者平台。這是首個面向自主機器人的開放式交鑰匙整合平台,融合 CPU、GPU、NPU 與 FPGA 的異質運算能力。
Kria AI SOM 此次採用 COM-HPC 外型規格的模組化設計,內建 X100 系列處理器,具備前述最多 16 個 Zen 5 核心,以及 AMD RDNA 3.5 GPU 核心、NPU 與 FPGA 能力,適合多代理式 AI 應用場景。
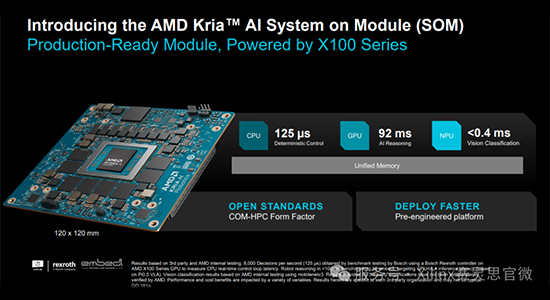
根據 AMD 官方資料顯示,Kria AI SOM 在採用 Bosch Rexroth 控制器的測試中,可達到 125μs 的控制迴路延遲,意味著即時控制每秒可執行超過 8,000 次控制決策;同時在 Pi0.5 VLA 模型測試中,VLA 的 AI 推論回應時間低於 100 毫秒。這些強大的效能表現,對需要快速且安全回應的實體 AI 應用具有重大意義,也意味著過去必須透過多晶片進行即時控制與 AI 推論的瓶頸得以突破,透過 Kria AI SOM 可大幅簡化實體 AI 系統的設計複雜度,並降低部署成本,為工業自動化、自主移動機器人等領域提供兼具效能與可靠性的運算基礎。
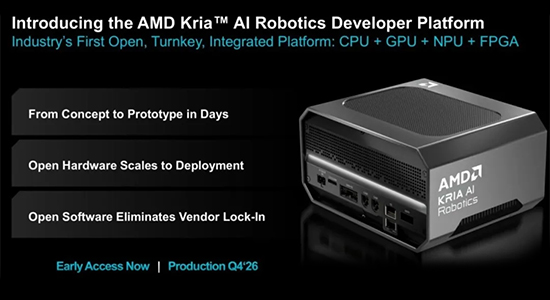
此次 AMD 與 Kria AI SOM 搭配的是 AMD Kria AI 機器人開發者平台,AMD 將其定位為「首個面向自主機器人的開放式交鑰匙整合平台」。
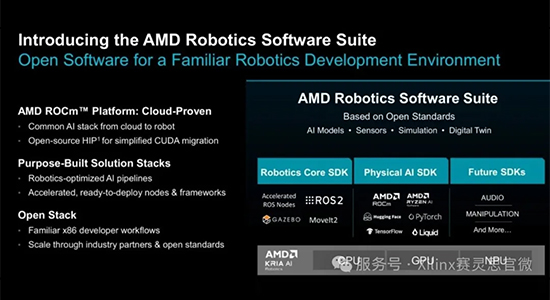
其中包含 Kria AI SOM 與機器人載板,以及評估套件、機器人軟體套件與經過驗證的參考設計。這套平台採用 AMD ROCm 與 ROS 2 機器人框架建構,主要針對端對端開發進行最佳化,支援 PyTorch、ONNX、ROS 2、MoveIt 等產業標準框架。同時因搭載 Ryzen AI 嵌入式 X100 系列處理器,因此開放式軟體堆疊支援 CUDA 至 ROCm 移轉;根據 AMD 內部測試,開發者最高可保留 75% 的既有 CUDA 程式碼,顯著降低移轉成本。
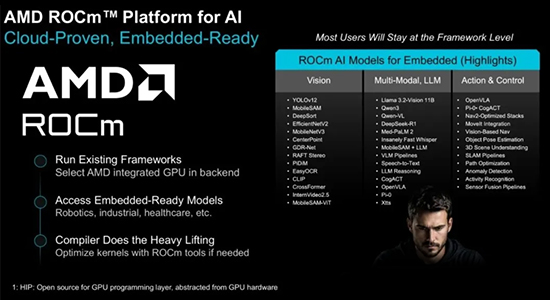
AMD 目前公布,Kria AI SOM 預計於 2026 年第四季透過 ODM 合作夥伴供貨。AMD Kria AI 機器人開發者平台目前已向早期客戶提供樣品,同樣預計於 2026 年第四季正式供貨。
03 - 合作共贏 AMD Robotics Partner Network 加速實體 AI 開放式生態系
最後來談談生態系。早年 AMD 曾在消費級生態系發展上遭遇挑戰,因此近年除了持續投入技術研發與迭代,也不斷拓展市場生態系,與眾多合作夥伴進行深度共創。在消費級領域,AMD 已證明產品、技術與生態系缺一不可,因此此次希望透過開放式軟硬體全端生態系推動實體 AI 發展,也符合其一貫的發展理念。尤其企業級市場競爭更加激烈,即使硬體與平台再強,若缺乏生態系協作也難以規模化,這也是 AMD 等上游廠商需要引領產業的重要一環,唯有合作才能共贏。
此次在推出 X100 系列處理器、Kria AI SOM 以及 AMD Kria AI 機器人開發者平台的同時,AMD 同步推出 AMD Robotics Partner Network,也就是機器人合作夥伴網路。顧名思義,AMD 希望匯聚 ODM 廠商、ISV、模擬供應商、感測器與感知技術公司、安全與基準測試合作夥伴,以及系統整合商,為實體 AI 領域建立統一硬體與開放標準的軟體基礎。
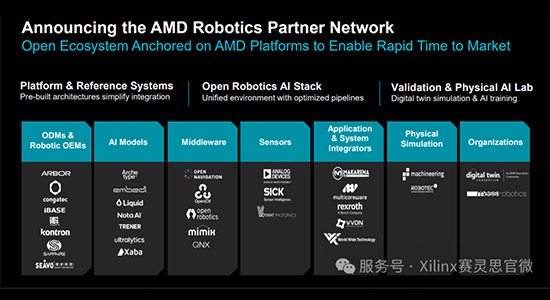
這套合作夥伴矩陣目前已涵蓋 AMD 的完整邊緣運算平台,也就是除了針對實體 AI 推出的 X100 系列處理器之外,還包括 Ryzen AI 嵌入式 P100 處理器、Versal 自適應 SoC,甚至 EPYC 處理器與 Instinct GPU。此次補齊實體 AI 領域的生態系缺口後,意味著 AMD 在 AI 領域已能涵蓋感知、規劃、控制、模擬、訓練與部署的完整流程。
此外,AMD 表示合作夥伴可使用 AMD ROS 2 Perception Node 加速應用程式、ROCm 開放式軟體生態系、Ryzen AI 軟體、Vitis AI 軟體及 ONNX 框架,真正實現更彈性的選擇
簡單來說,與 AMD 合作的開發者與企業,只要運用 AMD 提供的多套 AI 開發與加速工具,即可直接涵蓋機器人、嵌入式設備等不同應用場景,而且這套開放式生態系解決方案不綁定任何特定 AI 模型,開發者可自由選擇想使用的模型,不必為了配合工具而特別修改模型,可節省大量時間與人力成本。
目前加入 AMD Robotics Partner Network 的生態系會員門檻相當低:符合資格的企業與開發者可免費加入,且所有級別皆無需支付授權費或會員費。合作夥伴與開發者可透過發布經驗證、採用 AMD 平台的解決方案,提升會員等級,並取得聯合行銷、平台優先體驗等權益。
因此,無論企業或個人開發者皆能零成本加入,並可取得更多 AMD 官方合作資源與支援。這也是 AMD 針對實體 AI 產業提供的重要生態系支援,而 AMD Robotics Partner Network 的推出,也代表 AMD 正式將開放式生態系統模式擴展至機器人領域。
寫在最後
整體而言,AMD 在此次 Advancing AI 2026 大會上集中發表的 Ryzen AI 嵌入式 X100 系列處理器、Kria AI 解決方案及 AMD Robotics Partner Network,向企業與開發者展現完整的實體 AI 產品矩陣。這項布局直接回應產業對邊緣端智慧設備在高效能異質運算、確定性即時控制與低功耗運作方面的綜合需求,也展現 AMD 在累積消費級與資料中心 AI 技術實力後,持續探索工業、醫療與自主系統等實體應用場景。
從生態系布局角度來看,AMD 此次策略核心在於開放與全端。Kria AI 機器人開發者平台整合 ROCm、ROS 2、ONNX 等開放框架,並提供 CUDA 至 ROCm 的高比例程式碼移轉支援,大幅降低傳統機器人開發中軟硬體整合的門檻。Robotics Partner Network 則以零授權費、零會員費的方式吸引 ODM、ISV 等眾多產業廠商加入,實現針對實體 AI 產業的完整供應鏈協同部署。這種模式為開發者與企業提供更彈性的選擇空間,相較封閉式生態系更具長期發展潛力。
根據 AMD 預測,實體 AI 市場從 2025 年至 2035 年將呈現指數級成長,持續帶動邊緣運算與自主系統需求。AMD 具備高效能 CPU 與 GPU 的獨特優勢,如今已延伸至實體 AI 與機器人領域的開放式生態系,有望擴大在邊緣端與實體智慧領域的市場版圖。AMD 此次全端實體 AI 解決方案也將累積更多驗證案例,並持續提升軟體成熟度與擴大合作夥伴廣度。整體而言,AMD 正透過系統性布局,從 AI 領域的運算硬體創新者,逐步成長為涵蓋資料中心與實體邊緣各種場景的全端生態系建構者。筆者也相信,AMD 能持續憑藉深厚的技術累積與開放協作的產業策略,在高速發展的實體 AI 市場中不斷鞏固自身競爭優勢。
閱讀原文 |