|
AMD 布局物理 AI:从算力芯片到机器人生态
2026 年生成式 AI 应用正在持续爆发,全球科技产业正从数字智能向物理智能加速跃进。从人形机器人、手术机器人到智能工厂设备、自主物流系统等领域,机器人以及智能设备所能承载的任务愈发重要。而现在人们对于 AI 的要求也不再满足于云端推理或简单自动化,在 2020 年就被提出的物理 AI( Physical AI )概念,如今终于到了大展拳脚的时刻。
作为市面上唯一能同时生产高性能 CPU 和 GPU 的企业,AMD 也很快察觉这一市场动向,在几天时间的 Advancing AI 2026 大会上发布了锐龙 AI 嵌入式 X100 系列处理器,公布了 Kria AI 解决方案。同时介绍了全新 AMD Robotics Partner Network( AMD 机器人合作伙伴网络),
AMD 希望以开放的软硬件全栈生态推动物理 AI 在实体场景的规模化落地。
01 - 锐龙 AI 嵌入式 X100 系列处理器:专为物理 AI 而生
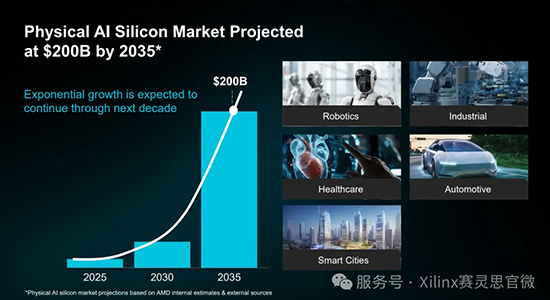
很多对行业不了解的用户,可能对物理 AI 还停留在概念中,事实上如果不是生成式 AI 的持续突破,物理 AI 也很难快速发展,不过迭代速度倒是超出了人们的想象,而这个市场潜力在行业有目共睹。根据 AMD 的预测,物理市场预计 2025 - 2035 年将保持指数级增长,并且很有可能在 2035 年达到 2000 亿美元的规模,意味着未来几年内我们很可能看到科幻电影游戏中的“智械”走进各大企业工厂发光发热。
而物理 AI 的崛起也标志着 AI 技术演进已进入新阶段。企业对于 AI 的要求也不在只能服务于生成式 AI 或者大语言模型,大家需要 AI 不仅能理解数据,更能在真实环境中感知推理,从而根据需要做出决策并安全执行动作。因此物理 AI 系统要求智能设备或者机器人必须在边缘以及嵌入式环境中同时满足多项严苛条件。需要设备在有限功耗散热条件下,实现高性能 AI 推理与确定性实时控制。
传统的 AI 方案或者机器人无法跟上物理 AI 的时代也不难理解,因为 AI 想要应用在各个领域,并非只需要打造单一硬件或者单一软件就能完成,而是需要一套完整的供应链体系,从底层硬件,到软件生态,都意味着这个行业需要一套覆盖软硬件的全产业矩阵引领。从而才能避免缺乏预验证,开发周期长,生态封闭等恶性环境循环而影响行业发展。
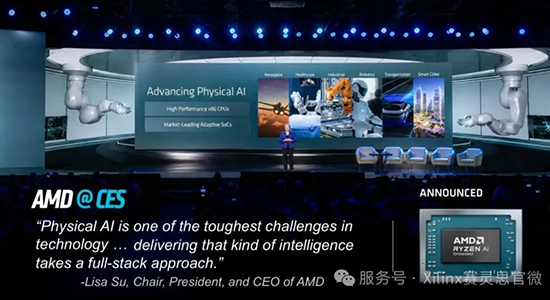
在今年的 CES 上,AMD 董事会主席及首席执行官 Lisa Su 博士就表示:“物理 AI 是技术领域中最棘手的挑战之一,而要实现这种级别的智能,必须采用全栈式解决方案。”所以在看到行业痛点需求以及市场前景后,AMD 在 Advancing AI 2026 大会的新品技术发布以及生态动向也不难理解了。
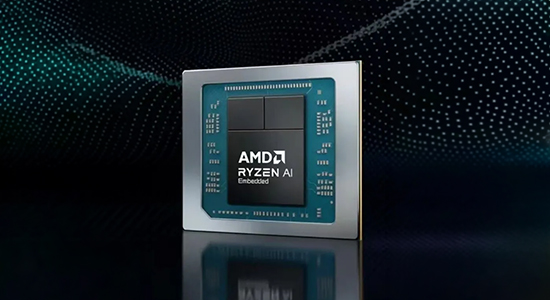
首先在产品端方面,AMD 的响应一如既往的迅速。AMD 本次发布的核心硬件是锐龙 AI 嵌入式 X100 系列处理器。X100 系列处理器就是专为物理 AI 工作负载设计,它在单颗嵌入式 SoC 上集成最多 16 个高性能 AMD Zen 5 CPU 核心,搭载 RDNA 3.5 架构的 iGPU 以及 50 TOPS 算力的 XDNA 2 NPU。 三大计算引擎均具备卓越独立性能,这点我们在消费级领域大家都已经耳熟能详。同时 X100 系列处理器统一内置 128GB 内存,最大加速频率 5.1GHz,可支持 7×24 小时全天候运行,使用寿命高达 10 年。
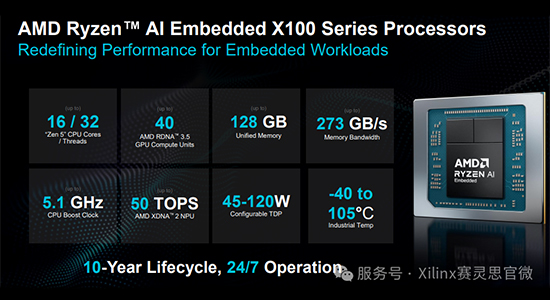
X100 系列处理器这次提供三款型号,分别为 X199、X188、X168。并且 AMD 为每个型号专门推出了常规版和i后缀版本的工业款,也就是说总共有 6 款 SKU。常规版工作温度范围在 0℃ 到 105℃,而工业版的工作温度范围则在 -40℃ 到 105℃。
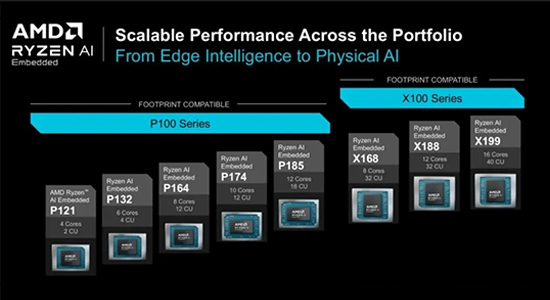
X199 为这次 X100 系列处理器的旗舰型号,拥有 16 核心 32 线程,GPU 配备 40 个 RDNA 3.5 计算单元。而 X188 则拥有 12 核心 24 线程,GPU 配备 32 个 RDNA 3.5 计算单元。X168 则拥有 8 核心 16 线程,GPU 同样配备 32 个 RDNA 3.5 计算单元。
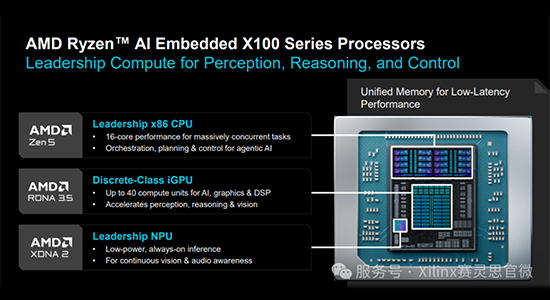
在性能应用方面,X100 系列依靠先进 Zen 5 架构带来的多核领先优势,配备工业自动化实时控制以及服务机器人运动闭环管控等需要实时控制与多任务处理的场景。并且强大的 RDNA 3.5 图形处理能力,能支撑智能设备进行更高性能的图形处理任务。在 AI 工作负载上,X100 系列也带来了更高的令牌生成吞吐量和更快的首个令牌生成时间( TTFT ),加速物理 AI 推理。同时信号处理方面,X100 系列强大的峰值 FP32 性能在高级医疗超声波束成形等应用上表现出色,平均性能也具备优势。
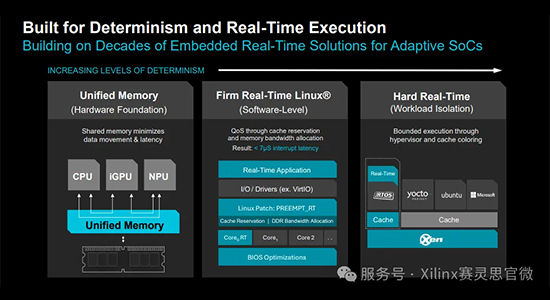
综合来看,X100 系列主要针对机器人,工业自动化,医疗健康及其他智能实时嵌入式系统优化,能在严格约束下支持自主系统可靠地感知推理和行动。
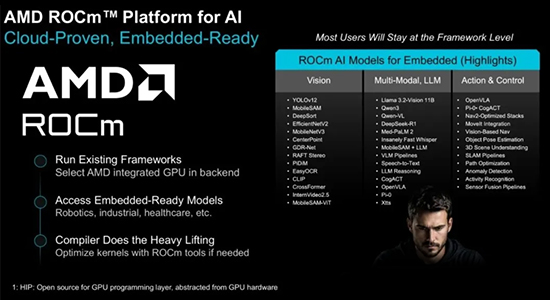
在软件的支持上,AMD 也为 X100 系列打好了基础,支持 Linux 操作系统、AMD ROCm 软件栈、Xen Hypervisor 虚拟化,以及 PyTorch、ONNX、TensorFlow 等主流 AI 框架。开发者可借助 CUDA 向 ROCm 迁移工具,在熟悉环境中快速构建应用。
目前 AMD 表示,X100 系列处理器已于 2026 年 6 月向客户提供样品,预计 2026 年第四季度量产。并且通过 Arbor、Congatec、iBase、IEI、Sapphire 和 Seavo 等首发合作伙伴的系统模块,客户可快速推进至量产阶段。
02 - Kria AI 解决方案让机器人更像人
我们前面也提到,AMD 目标是通过全栈生态推动物理 AI 的发展。锐龙 AI 嵌入式 X100 系列的推出,标志着物理 AI 的计算核心面世,还需要能够发挥这个核心的载体。在消费级领域这个载体是主板、是主机。而面向物理 AI 领域,AMD 在 X100 基础上,推出全新 Kria AI 解决方案,包括搭载 X100 系列处理器的 Kria AI SOM 和机器人载板,以及 Kria AI 机器人开发者平台。这是首个面向自主机器人的开放式交钥匙集成平台,因为它融合集成了 CPU、GPU、NPU 与 FPGA 的异构计算能力。
Kria AI SOM 这次采用 COM-HPC 外形规格模块化设计,内置 X100 系列处理器,拥有前面提到的最多 16 个 Zen 5 核心,以及 AMD RDNA 3.5 GPU 核心、NPU 与 FPGA 能力。适合多智能体的 AI 场景。
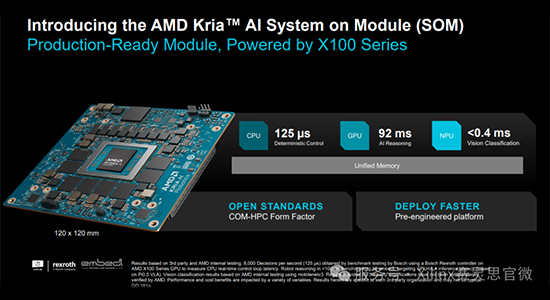
根据 AMD 官方的资料显示,Kria AI SOM 在基于 Bosch Rexroth 控制器测试下,可以达到 125μs 微秒控制回路时延,意味着能提供实时控制达到每秒超过 8000 次控制决策,同时针对 Pi0.5 VLA 模型测试的测试下,VLA 的 AI 推理响应时间低于 100 毫秒。这些强大的性能表现对需要快速以及安全响应的物理 AI 应用意义重大。意味着以前需要通过多芯片来进行实时控制和 AI 推理的瓶颈被打破,通过 Kria AI SOM 可以大幅简化物理AI系统的设计复杂度,并降低落地成本,为工业自动化,需要自主移动的机器人等领域提供了兼具性能与可靠性的算力基础。
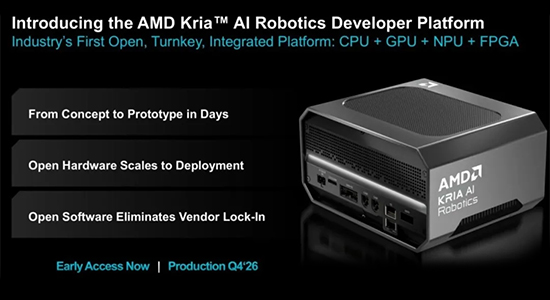
这次 AMD 与 Kria AI SOM 配套的是 AMD Kria AI 机器人开发者平台,AMD 将其被定位为“首个面向自主机器人的开放式交钥匙集成平台”。
它包含了 Kria AI SOM 与机器人载板,还有评估套件和机器人软件套件及业经验证的参考设计。这套平台由 AMD ROCm 与 ROS 2 机器人框架构建,主要针对端到端开发优化,支持 PyTorch、ONNX、ROS 2、MoveIt 等行业标准框架。同时因为搭载了锐龙 AI 嵌入式 X100 系列处理器,所以开放软件栈支持 CUDA 向 ROCm 迁移,根据 AMD 内部测试,开发者可保留最高达 75% 的现有 CUDA 代码,显著降低迁移成本。
AMD 目前公布,Kria AI SOM 预计 2026 年第四季度通过 ODM 合作伙伴供货。AMD Kria AI 机器人开发者平台则现已向早期客户提供样品,同于 2026 年第四季度正式供货。
03 - 合作共赢 AMD Robotics Partner Network 加速物理 AI 开放生态
最后我们聊一聊生态,早些年消费级的生态领域被卡脖子就给 AMD 上过一课,因此这些年除了不断在进行技术研发迭代,AMD 也不断开拓市场生态,与大量合作伙伴进行深度共创。在消费级领域 AMD 已经证明了产品、技术、生态缺一不可,所以这次 AMD 希望通过开放的软硬件全栈生态推动物理 AI 发展也符合其一贯的发展理念。尤其是企业级的竞争更为激烈,而硬件与平台再强,若缺乏生态协同也难以规模化,这也是 AMD 这样的上游厂商需要引领行业的重要一环,合作才能共赢。
这次在推出了 X100 系列处理器、Kria AI SOM 以及 AMD Kria AI 机器人开发者平台,AMD 同步推出了 AMD Robotics Partner Network,也就是机器人合作伙伴网络,功能也如名字一样,AMD 希望汇聚 ODM 厂商、ISV、仿真提供商、传感器与感知技术公司、安全与基准测试伙伴以及系统集成商,为物理 AI 领域也形成统一硬件与开放标准软件基础。
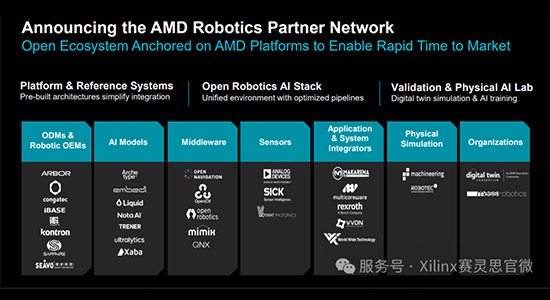
这套合作伙伴的矩阵,目前已经覆盖 AMD 的边缘全计算平台,也就是除了针对物理 AI 推出的 X100 系列处理器,还包括锐龙 AI 嵌入式 P100 处理器、Versal 自适应 SoC 甚至 EPYC 处理器和 Instinct GPU。这次在补全物理 AI 领域的生态空缺后,这意味着通过 AMD 在针对 AI 领域已经能够实现感知、规划、控制、仿真、训练与部署全链路。
并且 AMD 表示合作伙伴可使用 AMD ROS 2 Perception Node 加速应用、ROCm 开放软件生态、Ryzen AI 软件、Vitis AI软件及 ONNX 框架,真正实现更灵活的选择
简单点来说,这些和 AMD 合作的开发者以及企业,直用 AMD 提供的多套 AI 开发与加速工具,就能直接覆盖机器人、嵌入式设备等不同场景,而且这套开放生态方案不绑定任何特定的 AI 模型,开发者可以自由选择想用的模型,不用为了适配工具专门修改模型,节省大量时间以及人力成本。
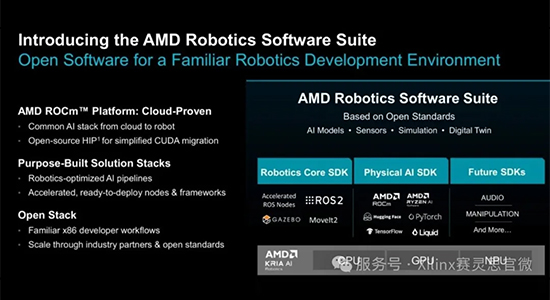
目前加入 AMD Robotics Partner Network 的生态会员门槛很低:符合条件的企业和开发者可免费加入,并且所有级别均无需许可费或会员费。而合作伙伴和开发者可以通过发布经验证的基于 AMD 平台的解决方案,提升会员等级,获得联合营销、平台抢先体验等权益。
所以不管是企业还是个人开发者,都能零成本加入进来,在里面创作就能解锁更多 AMD 官方合作福利与资源支持。这也是 AMD 针对物理 AI 行业给予的最有力生态支持,而 AMD Robotics Partner Network 的推出也意味着 AMD 正式将开放生态系统模式扩展至机器人领域。
写在最后
总的来说,AMD 在这次 Advancing AI 2026 大会上集中发布的锐龙 AI 嵌入式 X100 系列处理器、Kria AI 解决方案及 AMD Robotics Partner Network,为广大企业和开发者展现了完整物理 AI 产品矩阵。这一布局直接回应了行业对于边缘侧智能设备对高性能异构计算,确定性实时控制与低功耗运行的综合需求,也体现了 AMD 在完成了消费级与数据中心 AI 技术积累后,向工业、医疗与自主系统等物理场景的探索和研究精神。
从生态布局角度看,AMD 此次的策略核心在于开放与全栈。Kria AI 机器人开发者平台整合 ROCm、ROS 2、ONNX 等开放框架,并提供 CUDA 向 ROCm 的高比例代码迁移支持,大幅降低了传统机器人开发中软硬件适配的门槛。Robotics Partner Network 则以零许可费零会员费的方式吸纳 ODM、ISV 等大量行业厂商,实现针对物理 AI 行业的全产业链协同部署。这种模式为开发者和企业提供了更灵活的选择空间,相比封闭生态更具长期发展潜力。
根据 AMD 预测,物理 AI 市场从 2025 年到 2035 年会呈现指数级增长,将持续拉动边缘计算与自主系统需求。AMD 具备高性能 CPU 与 GPU 的独特优势,已经延伸至物理 AI 机器人领域的开放生态,有望扩大在边缘侧与物理智能领域的份额。AMD 这次全栈物理 AI 解决方案也会积累更多验证案例,并持续完善软件成熟度与合作伙伴广度。总体而言,AMD 正通过系统性布局,从 AI 领域的算力硬件创造者,成长为覆盖数据中心与物理边缘全场景的全栈生态构建者,并且笔者也相信 AMD 能够继续凭借技术积淀与开放协作的产业策略,在高速发展的物理 AI 市场中不断夯实自身的竞争优势。
阅读原文 |