|
AMD:做了 20 年的機器人「身體」,正式加入「大腦」競爭
2026 年,實體 AI 成為運算產業最明確的發展方向之一。年初在 CES 上,AMD 董事會主席暨執行長蘇姿丰( Lisa Su )博士就给出一个判断:實體 AI 是技術領域最艱鉅的挑戰之一——要實現這種智慧,需要全端方法。這句話值得反覆思考,尤其是「全端」,正是 AMD 近年在許多場合反覆強調的關鍵字。
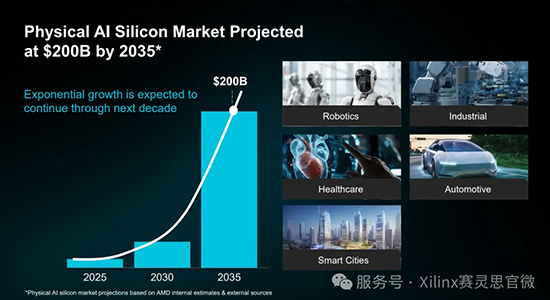
市場規模的預期也持續攀升。AMD 預估,實體 AI 晶片市場將從 2025 年起持續快速成長,到 2035 年達到約 2,000 億美元,涵蓋機器人、工業、醫療、汽車、智慧城市等應用場域。
在甫落幕的 AMD 年度大會 Advancing AI 2026 上,AMD 發表一整套實體 AI 產品:針對機器人的 Ryzen AI 嵌入式 X100 系列處理器、Kria AI 機器人開發者平台與機器人軟體套件。同時,AMD 也宣布推出機器人合作夥伴網路,該網路匯集 ODM 廠商、AI 模型供應商、中介軟體、感測器、機器人技術及系統整合等領域的眾多合作夥伴。
至此,AMD 在實體 AI 領域的策略已相當清晰:一家憑藉 FPGA 在機器人「身體」領域深耕二十多年的公司,正式開始打造機器人的「大腦」。
01 - 20 年「身體」累積,
AMD 向「大腦」市場邁進
「實體 AI」多年前就已存在,只是當時的稱呼不同。不過,它的基本架構始終未變:感知( sense )、理解( perceive )與行動( act )。
對 AMD 而言,感知一直是 FPGA 的主場。FPGA 擁有可程式化 I/O,本質上是一顆可重新編程以扮演各種角色的客製化晶片,天生適合感測器融合、資料彙整與影像整合;FPGA 帶來的另一項優勢是確定性,例如確定性網路與可預測延遲,這些對機器人都至關重要;行動環節也是如此:驅動馬達、轉動伺服馬達、控制閥門開關……都是 FPGA 的核心強項。
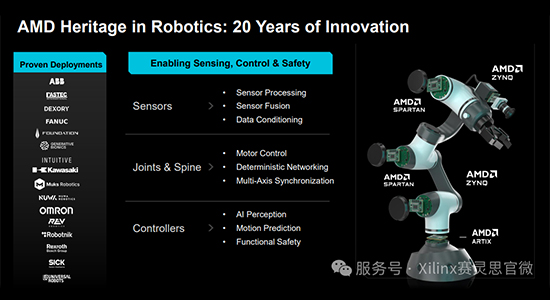
此外,機器在實體世界與人互動時,功能安全至關重要。這也是 AMD 長期累積的優勢——來自汽車與工業領域的功能安全能力,已在手術機器人、工業產線等應用場域通過量產驗證,如今更延伸至人形機器人時代。
對人形機器人而言,「感知、理解、行動」這套能力對應的是身體的感測器、關節與脊柱。在傳統自動化時代,機器人的智慧程度有限,最重要的是即時性與可靠性,FPGA 與自適應 SoC 足以支撐這個市場的需求。
但實體 AI 改變了機器人產業的價值分布。當機器人從「依程式動作」走向「感知、推論、決策」,大腦——也就是 AI 推論與代理式 AI 決策,成為機器人整機價值最高、迭代最快的部分。理解周遭環境、追蹤移動物體、解析場景、規劃路徑與安全執行,這些都需要大腦具備相當的運算能力。而這個市場,AMD 過去一直缺席。
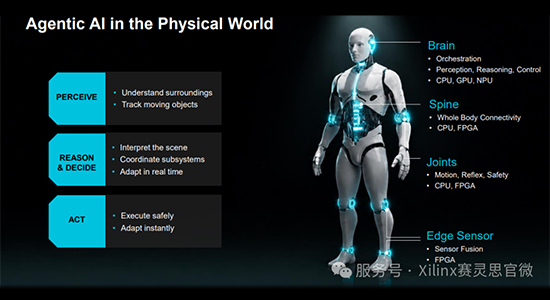
AMD 嵌入式事業產品、軟體與解決方案公司副總裁 Kirk Saban,提出了一個頗具啟發性的觀點:「代理式 AI 的終極型態,就是人形機器人。」 換言之,當整個產業都在談代理式 AI 時,機器人才是最適合的實體載體,而 AMD 要做的,就是將能力從機器人身體延伸至機器人大腦。
因此,這次大會發表的 AMD Ryzen AI 嵌入式 X100 系列處理器與 AMD Kria AI 解決方案,並非對新品類的試探,而是隨著價值鏈向上延伸的必然布局。
02 - 機器人大腦晶片
為什麼和資料中心不一樣?
打造機器人的大腦,是否只要把資料中心的運算能力縮小即可?答案是否定的。
Kirk Saban 表示,機器人大腦需要進行路徑規劃與感知,不能只看峰值 TOPS,最根本的是確定性,可預測的時序是絕對必要的。
這並非單方面的觀點,來自開發者社群與使用者的回饋也高度一致。例如 2026 年 2 月,AMD 贊助一項針對全球 177 名機器人開發者的調查,排名前三的需求依序為:第一,確定性高於峰值運算能力;第二,開放式架構,避免供應商綁定;第三,一個平台適用所有機器人,並在功耗、散熱與即時性限制下提供可用效能。
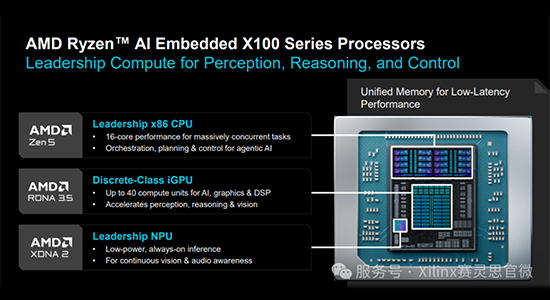
AMD Ryzen AI 嵌入式 X100 系列處理器正是針對這些需求打造的產品。先看運算架構:X100 在單顆嵌入式 SoC 上整合最多 16 個高效能 AMD「Zen 5」CPU、獨立顯示卡等級的整合式 GPU,以及高能源效率 NPU,負責低功耗、持續在線的推論,例如持續進行視覺與音訊感知。
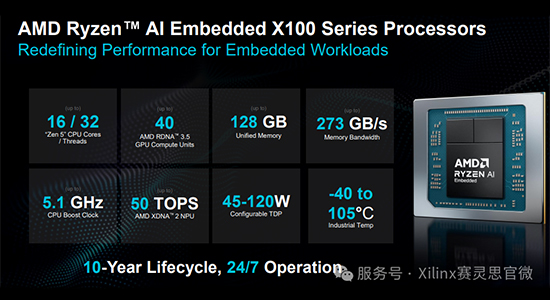
另一項關鍵技術是統一記憶體架構:最高 128GB 容量、273GB/s 頻寬,CPU、GPU、NPU 之間可零拷貝交換資料。
為什麼這一點對機器人格外重要?傳統 CPU+外接加速器架構相當分散,感知、規劃、控制等數百個並行執行緒必須在不同運算域之間反覆搬移資料,每個週期都會耗費時間;而在整合式架構下,高效能 CPU 與 AI 加速器可在同一記憶體上運作,實現零拷貝。
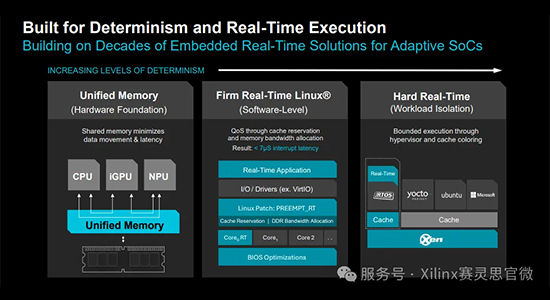
此外,硬即時能力也有助於提升確定性。X100 透過統一記憶體的工作負載隔離、PREEMPT_RT 即時 Linux 修補程式、快取預留與記憶體頻寬分配等技術,實現低於 7 微秒的中斷延遲。
此外,嵌入式領域還有一項基本門檻:10 年產品生命週期、全年無休運作、-40°C 至 105°C 的工業溫度範圍,以及 45W 至 120W 可設定 TDP——這也正是 AMD 嵌入式事業部數十年來的核心優勢。
今年 1 月 CES 上,AMD 已發表針對邊緣智慧的 P100 系列,X100 延續其設計,兩者腳位相容。Kirk Saban 强调,這顆晶片是 AMD 機器人大腦布局的起點,未來產品藍圖將持續推進。
03 - 從晶片到「交鑰匙」,AMD「開放」理念貫穿始終
對機器人使用者而言,一大挑戰在於如何從開發順利走向量產。AMD 此次發表的 Kria AI 解決方案,就是為了降低使用門檻並加速量產。
這套解決方案分為兩大部分:一是搭載 X100 的 Kria AI 系統模組( SOM )與機器人載板;二是 Kria AI 機器人開發者平台( Kria AI Robotics Developer Platform )。
SOM 並不是新的產品型態,AMD 在這個領域已有多年累積——簡單來說,它是一塊預先完成工程設計的板卡,記憶體介面、設定介面等工作都由 AMD 預先完成,客戶插入基板即可使用,省去最耗時的硬體前期開發。
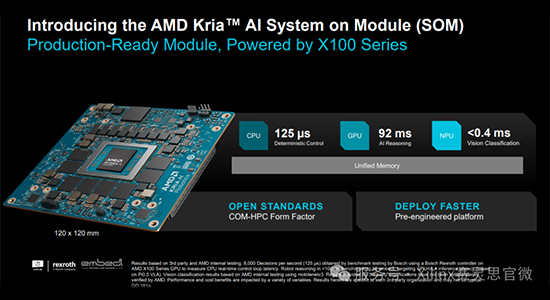
最新 Kria AI SOM 搭載 X100 處理器,採用 COM-HPC 開放標準外型( 120×120mm ),將異質運算、統一記憶體、每秒 8,000 次控制決策的即時控制能力,以及低於 100 毫秒的 VLA 推論,全部整合在這塊掌心大小的模組中。更關鍵的是其生態策略:整個 SOM 生態系向 ODM 合作夥伴網路開放,客戶可客製化載板,依應用需求在效能、功耗與成本之間彈性選配,進而快速邁向量產。
此外,AMD 也推出 Kria AI 機器人開發者平台,並表示這是首個針對自主機器人的開放式交鑰匙整合平台,融合 CPU、GPU、NPU 與 FPGA 的異質運算能力。其介面配置完全依機器人需求設計——正面配置時間敏感網路( TSN )輸入、攝影機介面等機器人專用連接,背面則為乙太網路、USB、顯示等標準介面。
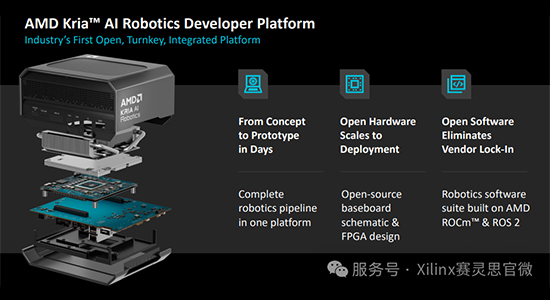
這個平台最吸引開發者的設計,也是「交鑰匙」真正的意義:開發者在桌面上除錯使用的 SOM,與未來透過合作夥伴生態系作為量產模組出貨的,是同一款產品。從概念到原型只需數天,開發完成後即可直接轉入上市流程。
此外,比硬體更值得注意的是「開放」理念的落實程度:SOM 採用開放標準,基板電路圖作為參考設計向客戶開放,載板上的 FPGA RTL 設計也將開源,方便客戶依需求修改並快速上市。
軟體堆疊同樣沿著開放路線發展。AMD 機器人軟體套件以 ROCm 與 ROS 2 為基礎建構,支援 PyTorch、ONNX、MoveIt 等產業標準框架,模型庫已涵蓋 OpenVLA、Pi-0、CogACT 等主流 VLA 模型,以及 Llama 3.2-Vision、Qwen3、DeepSeek-R1 等多模態模型。
由於 ROCm 適用於 AMD 全系列 GPU,Instinct 資料中心端的軟體創新將持續整合至同一個程式碼庫,這意味著開發者可在雲端使用 Instinct GPU 訓練機器人基礎模型,再以同一套軟體堆疊部署至 X100。雲端訓練、機器人端部署——這也是 AMD 全端策略在實體 AI 上最具體的呈現。
根據 AMD 測試結果,AMD 開放式軟體堆疊支援從 CUDA 移轉至 ROCm,開發者最高可保留 75% 的既有 CUDA 程式碼,並藉由 AMD 開放且垂直整合的機器人軟體套件加速開發。
除了開放式硬體與軟體支援之外,AMD 在生態系方面也延續相同的開放策略。
会上,AMD 宣布推出 Robotics Partner Network(機器人合作夥伴網路),該計畫透過統一的 AMD 硬體與以開放標準建構的軟體基礎,將 ODM、ISV、模擬供應商、感測器與感知技術公司、安全與基準測試合作夥伴,以及系統整合商串聯起來。
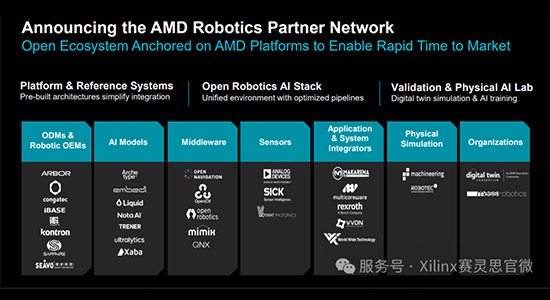
AMD 打造機器人合作夥伴網路的實際背景,源自產業長期存在的整合痛點:AI 模型、中介軟體、感測器、模擬工具、系統整合商及生產硬體等元件往往來自不同供應商,彼此之間缺乏驗證。
AMD 嵌入式事業工業、機器人與醫療市場資深總監 Amey Deosthali 表示,沒有任何一家企業能夠獨自建構實體 AI 的未來,透過 AMD 機器人合作夥伴網路,可減少整合工作量、縮短開發週期,並讓機器人專家以更高的彈性與可移植性,從參考平台邁向量產系統。
據了解,這項計畫涵蓋 AMD 從邊緣系統(採用 AMD Ryzen AI 嵌入式處理器與 AMD Versal 自適應 SoC)到資料中心基礎設施(採用 AMD EPYC 處理器與 AMD Instinct GPU)的運算平台,旨在為客戶提供開放、經過驗證且可量產的機器人解決方案,涵蓋感知、規劃、控制、模擬、訓練與部署等環節。
寫在最後
二十多年前,FPGA 賦予機器人感知與行動能力;如今,AMD 想讓機器人學會如何思考。回顧 AMD 在實體 AI 領域的最新布局,涵蓋晶片、開發平台、量產模組、開放軟體與開放生態系五大方向,目標相當明確:將二十年來在機器人「身體」領域累積的確定性與產業經驗,延伸至「大腦」這個價值最高的領域。
而機器人大腦之爭不會只是資料中心競爭的簡單延續。資料中心比的是峰值運算能力,機器人比的是每一毫秒的確定性;資料中心可以靠單點效能取勝,機器人卻必須仰賴整條產業鏈協同驗證。AMD 著力的三大支點——確定性、開放與全端,恰好都是這個產業長期面臨、也最難僅靠一顆晶片解決的問題。這場競爭的核心,更在於誰能將可靠性做到極致,並真正落實生態系合作。
對相關產業鏈而言,這項訊號同樣值得重視:機器人「大腦」的市場格局仍未定型,發展機會依然存在。如何在高度碎片化的應用場域中找到長期發展方向,並建立獨特競爭力——這是 AMD 必須回答的問題,也是所有業者共同面臨的挑戰。
閱讀原文 |