|
AMD:做了 20 年的机器人“身体”,正式入局“大脑”竞争
2026 年,物理 AI 成为算力产业最确定的方向之一。年初在 CES 上,AMD 董事会主席及首席执行官苏姿丰( Lisa Su )博士就给出一个判断:物理 AI 是技术领域最艰难的挑战之一——交付这种智能,需要全栈方法。这句话值得反复推敲,特别是“全栈”,恰恰是AMD这几年在多数场合反复强调的关键词。
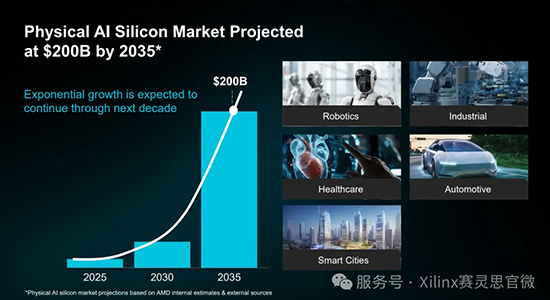
市场规模的预期也在不断抬升。AMD 给出的预估是,物理 AI 芯片市场将从 2025 年起持续跨越式增长,到 2035 年达到约 2000 亿美元,覆盖机器人、工业、医疗、汽车、智慧城市等场景。
在刚刚落幕的 AMD 年度大会 Advancing AI 2026 上,AMD 发布了一整套物理 AI 产品:面向机器人的锐龙 AI 嵌入式 X100 系列处理器、Kria AI 机器人开发者平台和机器人软件套件。同时,AMD 还宣布了机器人合作伙伴网络,该网络汇集了 ODM 厂商、AI 模型提供商、中间件、传感器、机器人技术及系统集成等领域的众多伙伴。
至此,AMD 在物理 AI 领域的战略已经非常清晰:一家靠 FPGA 在机器人"身体"里深耕了二十多年的公司,正式开始做机器人的"大脑"。
01 - 20 年“身体”积淀,
AMD 向“大脑”市场迈进
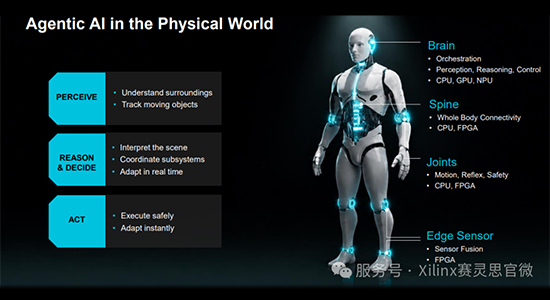
"物理 AI"多年前就已存在,只是当时的称谓不同。不过,它的基本框架始终没变:感知( sense )、理解( perceive )和行动( act )。
对于 AMD 来说,感知一直是其 FPGA 的主场。FPGA 拥有可编程 I/O,本质上是一块可以重编程成任何角色的定制芯片,天然适合传感融合、数据聚合与图像汇聚;FPGA 带来的另一样东西是确定性,比如确定性网络、可预测时延,这些对机器人都至关重要;行动环节同样如此:驱动电机、转动舵机、开合阀门……都是 FPGA 的看家本领。
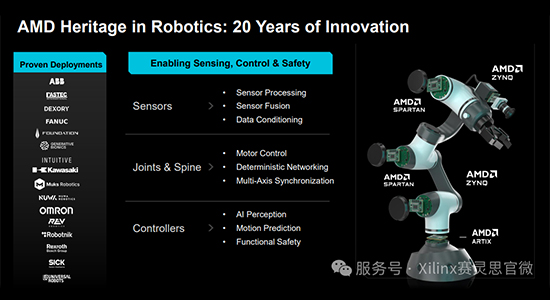
此外,机器在物理世界与人进行交互,功能安全至高无上。这也是 AMD 的积累所在——来自汽车和工业领域的功能安全能力,已在手术机器人、工业产线等场景经过量产验证,如今被带进人形机器人时代。
对于人形机器人来说,“感知、理解、行动”这套能力对应的是身体的传感器、关节、脊柱。在传统的自动化时代,机器人智能含量有限,最贵的是实时性和可靠性,FPGA 和自适应 SoC 足够支撑这块市场的需求。
但物理AI改变了机器人产业的价值分布。当机器人从"按程序动作"走向“感知、推理、决策”,大脑——也就是 AI 推理与智能体决策,成为机器人整机价值最高、迭代最快的部分。理解周围环境、追踪移动物体、解读场景、规划路径、安全执行,这些都需要大脑具备可观的算力。而这块市场,AMD 一直缺席。
AMD 嵌入式业务产品、软件与解决方案公司副总裁 Kirk Saban,有一个颇具启发意义的表述:"智能体的终极形态,就是人形机器人。" 言下之意,当整个产业都在谈智能体时,机器人才是智能体最适合的物理载体,而 AMD 要做的,是把能力从机器人身体扩展到机器人大脑。
因此,这次大会发布的 AMD Ryzen(锐龙)AI 嵌入式 X100 系列处理器和 AMD Kria AI 解决方案,并不是一次新品类的试探,而是随着价值链的必然上移。
02 - 机器人大脑芯片
为什么和数据中心不一样?
做机器人的大脑,是不是把数据中心的算力缩小就可以了?答案是否定的。
Kirk Saban 表示,机器人大脑需要做路径规划和感知,不能只看峰值 TOPS,最根本的是确定性,可预测的时序是绝对刚需。
这不是一家之言,来自于开发者社区和用户的反馈也非常一致。例如 2026 年 2 月,AMD 赞助了一项针对全球 177 名机器人开发者的调研,排在前三的需求依次是:第一,确定性高于峰值算力;第二,开放架构,避免供应商锁定;第三,一个平台适配所有机器人,在功耗、散热和实时约束内提供可用性能。
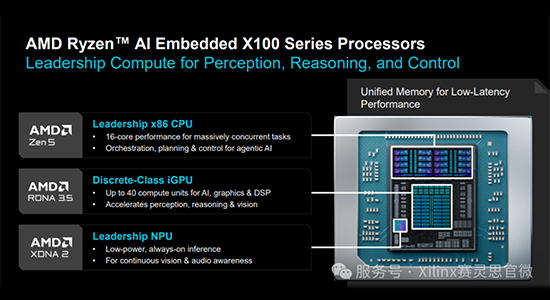
AMD 锐龙 AI 嵌入式 X100 系列处理器就是对应这些需求的一款产品。先看算力构成:X100 在单颗嵌入式 SoC 上集成了最多 16 个高性能 AMD“Zen 5”CPU、独立级集成 GPU 以及高能效 NPU,负责低功耗、常驻在线的推理,比如持续的视觉和音频感知。
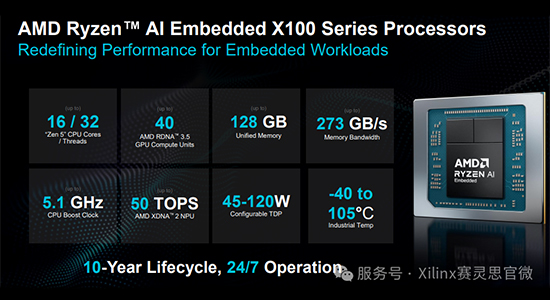
关键技术还有统一内存架构:最高 128GB 容量、273GB/s 带宽,CPU、GPU、NPU 之间零拷贝交换数据。
为什么这点对机器人格外重要?传统的 CPU+外挂加速器架构是碎片化的,感知、规划、控制数百个并发线程在不同计算域之间来回搬运数据,每个周期都在损失时间;而集成式架构下,高性能 CPU 与 AI 加速器在同一块内存上工作,实现零拷贝。
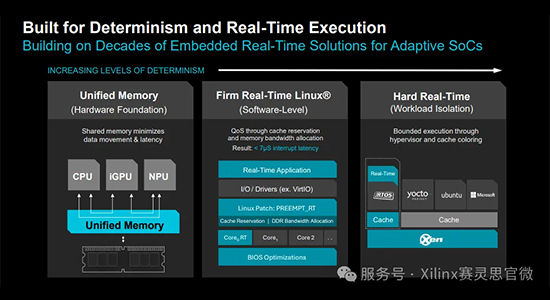
此外,硬实时能力也有助于提升确定性。X100 通过统一内存的工作负载隔离、PREEMPT_RT 实时 Linux 补丁、缓存预留与内存带宽分配等,实现了小于 7 微秒的中断延迟。
还有一条嵌入式领域的基本门槛:10 年产品生命周期、7×24 小时运行、-40°C 至 105°C 的工业温度范围、45W 至 120W 可配置 TDP——这也恰恰是 AMD 嵌入式事业部几十年来的立身之本。
今年 1 月 CES 上,AMD 已发布面向边缘智能的 P100 家族,X100 是其延续,两者引脚兼容。Kirk Saban 强调,这颗芯片是 AMD 机器人大脑征程的起点,未来路线图会持续推进。
03 - 从芯片到"交钥匙",AMD“开放”理念贯穿
对机器人用户来说,很大的一个挑战在于从开发到量产的一段路。AMD 这次发布的 Kria AI 解决方案,就是为了降低使用门槛、加速量产而来的。
这套方案分两大部分,一是搭载了 X100 的 Kria AI 系统模块( SOM )和机器人载板,二是 Kria AI 机器人开发者平台( Kria AI Robotics Developer Platform )。
SOM 并不是新产品形态,AMD 在这个领域已有多年积累——通俗讲,它是一块预先完成工程设计的板卡,内存接口、配置接口等工作 AMD 都预先做好,客户插进基板就能用,省去了最耗时的硬件前期工作。
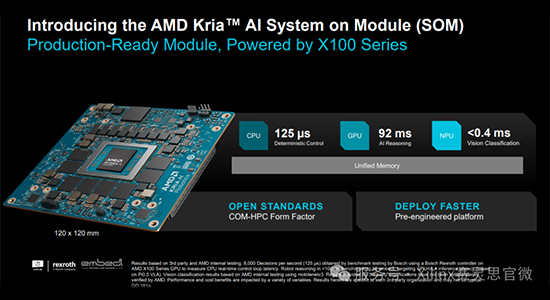
最新的 Kria AI SOM 搭载 X100 处理器,采用 COM-HPC 开放标准外形( 120×120mm ),异构算力、统一内存、每秒 8000 次控制决策的实时控制能力和低于 100 毫秒的 VLA 推理,全部浓缩在这块掌心大小的模块上。更关键的是其生态策略:整个 SOM 生态向 ODM 伙伴网络开放,客户可以定制载板,按应用在性能、功耗、成本之间灵活选配,从而快速走向量产。
此外,AMD 还推出了 Kria AI 机器人开发者平台,并宣称这是首个面向自主机器人的开放式交钥匙集成平台,融合了 CPU、GPU、NPU 与 FPGA 的异构计算能力。其接口布局完全按机器人需求设计——正面是时间敏感网络( TSN )输入、相机接口等机器人专用连接,背面则是以太网、USB、显示等标准接口。
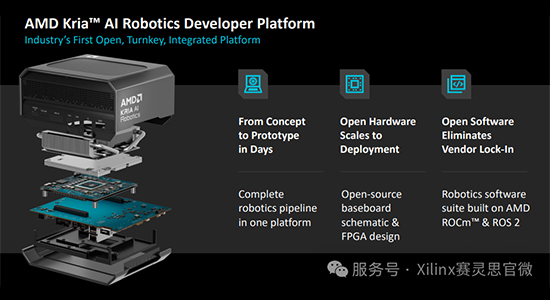
这个平台最打动开发者的设计,也是其“交钥匙”的真正含义:开发者桌上调试用的 SOM,和将来通过伙伴生态作为量产模块出货的,是同一颗。从概念到原型只需几天,开发完成即可直接转化上市。
此外,比硬件更值得注意的是"开放"二字的落地程度:SOM 采用开放标准,基板原理图作为参考设计向客户开放,载板上 FPGA 的 RTL 设计也将开源,方便客户按需改动、快速上市。
软件栈同样沿着开放路线展开。AMD 机器人软件套件基于 ROCm 与 ROS 2 构建,支持 PyTorch、ONNX、MoveIt 等行业标准框架,模型库已覆盖 OpenVLA、Pi-0、CogACT 等 VLA 主流模型,以及 Llama 3.2-Vision、Qwen3、DeepSeek-R1 等多模态模型。
由于 ROCm 适用于 AMD 全线 GPU,Instinct 数据中心端的软件创新会持续进入同一个代码库,这意味着开发者可以在云端用 Instinct GPU 训练机器人基础模型,再用同一套软件栈部署到 X100 上。云端训练、机器人端部署——这也是 AMD 全栈战略在物理 AI 上最具体的呈现。
根据 AMD 测试结果,AMD 开放软件栈支持从 CUDA 向 ROCm 迁移,开发者可保留最高达 75% 的现有 CUDA 代码,借助 AMD 开放且垂直整合的机器人软件套件加速开发。
开放的硬件和软件支持之外,AMD 在生态方面也是一脉相承的开放战略。
会上,AMD 宣布推出 Robotics Partner Network(机器人合作伙伴网络),该计划通过统一的 AMD 硬件和基于开放标准构建的软件基础,将ODM、ISV、仿真提供商、传感器与感知技术公司、安全与基准测试合作伙伴以及系统集成商连接起来。
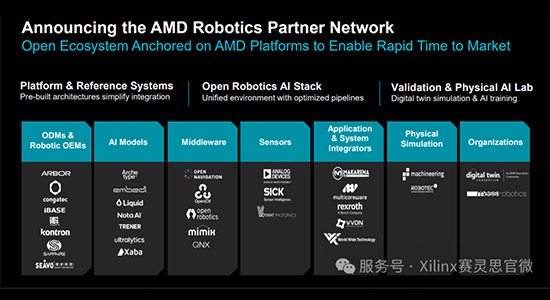
AMD 打造机器人合作伙伴网络的现实依据,源于行业由来已久的集成痛点:AI 模型、中间件、传感器、仿真工具、系统集成商以及生产硬件等,这些组件往往来自不同的供应商,彼此之间缺乏验证。
AMD 嵌入式业务工业、机器人与医疗市场高级总监 Amey Deosthali 谈到,没有任何一家企业能够独自构建物理 AI 的未来, 通过 AMD 机器人合作伙伴网络,可以减少集成工作量、缩短开发周期,并使机器人专家能够以更高的灵活性、可移植性,从参考平台迈向量产系统。
据了解,这一计划涵盖 AMD 从边缘系统(基于 AMD 锐龙 AI 嵌入式处理器和 AMD Versal 自适应 SoC )到数据中心基础设施(基于 AMD EPYC 处理器和AMD Instinct GPU )的计算平台,旨在为客户提供开放、经过验证且量产就绪的机器人解决方案,覆盖感知、规划、控制、仿真、训练和部署环节。
写在最后
二十多年前,FPGA 赋予机器人感知和行动能力;现在,AMD 想教机器人如何思考。回看 AMD 在物理 AI 领域的最新动向,覆盖芯片、开发平台、量产模块、开放软件、开放生态五大方向,指向非常明确:把二十年在机器人"身体"积累的确定性与产业经验,延伸到"大脑"这块价值最高的版图上。
而机器人大脑之争不会是数据中心的简单延续。数据中心比的是峰值算力,机器人比的是确定的每一毫秒;数据中心可以靠单点性能制胜,机器人却必须依赖一整条产业链的协同验证。AMD 发力的三个支点——确定性、开放、全栈,恰恰都是这个行业被抱怨最久、也最难用一颗芯片解决的问题。这场竞争的核心,更关乎谁能把可靠性做到极致,把生态合作落到实处。
对国内产业链来说,这个信号同样值得重视:机器人"大脑"的格局远未定型,窗口期仍然存在。如何在这个极度碎片化的场景里找到长期的方向,并形成独有的竞争力——这是 AMD 要回答的问题,也是所有玩家共同的挑战。
阅读原文 |